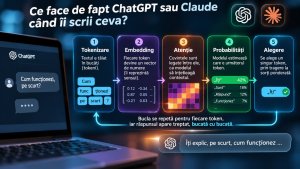
În primul articol din serie am văzut ce face un asistent AI când îi scrii: îți taie textul în tokeni, leagă cuvintele între ele prin mecanismul de atenție, dă o probabilitate fiecărei continuări posibile și alege una. A rămas însă deschisă întrebarea cea mai importantă: de unde vin acele probabilități? De unde „știe” modelul că după „Cel mai înalt vârf din România este” urmează, cel mai probabil, „Moldoveanu”?
Răspunsul scurt: nu i-a spus nimeni. Nimeni nu a scris în interiorul lui reguli de gramatică, liste de capitale sau manuale de programare. Tot ce știe a învățat dintr-o cantitate uriașă de text, printr-un proces numit antrenare.
În acest articol vedem cum arată acest proces, de ce costă zeci sau sute de milioane de dolari (iar cele mai noi, după estimări, și mai mult), cum devine un „ghicitor de text” un asistent politicos și de ce are o dată după care nu mai știe ce s-a întâmplat în lume. Vedem și de ce româna pornește în dezavantaj și ce controverse a stârnit totul.
Un model nou-nouț nu știe nimic
Un model lingvistic e format, în esență, din miliarde de numere numite parametri. Cel mai ușor e să ți-i imaginezi ca pe butoanele unei mese de mixaj uriașe: miliarde de butoane, fiecare cu poziția lui. Poziția fiecărui buton influențează puțin probabilitățile despre care vorbeam data trecută. Schimbi butoanele și se schimbă felul în care modelul continuă un text.
Niciun buton nu conține singur o informație. Nu există un buton pentru „Paris” sau unul pentru gramatica românească. Cunoștințele modelului stau în combinația de poziții a tuturor butoanelor.
La început, butoanele sunt puse la întâmplare. Un model abia creat scoate doar aiureli: litere și bucăți de cuvinte fără nicio legătură între ele. Antrenarea înseamnă găsirea poziției potrivite pentru fiecare buton. Nu le reglează nimeni de mână, pentru că sunt mult prea multe. Le reglează un algoritm, pe baza unui singur exercițiu repetat la nesfârșit.
Etapa 1: preantrenarea, cel mai mare joc de „ghicește cuvântul următor” din istorie
Ce citește modelul
Firmele care antrenează modele nu aleg articolele unul câte unul. Adună tot ce pot: pagini web (în mare parte din Common Crawl, o arhivă publică a internetului), cărți, Wikipedia, articole științifice, forumuri, cod de pe GitHub.
Cantitățile sunt greu de imaginat. Llama 3, modelul lansat de Meta în 2024, a fost antrenat pe aproximativ 15.000 de miliarde de tokeni. Un om care ar citi zi și noapte, fără nicio pauză, ar avea nevoie de circa 85.000 de ani ca să parcurgă atâta text. Chiar și pentru datele lui GPT-3, un model din 2020, mult mai mic, antrenat pe în jur de 300 de miliarde de tokeni, i-ar trebui aproximativ 1.700 de ani.
Exercițiul
Antrenarea propriu-zisă e un exercițiu simplu, repetat de mii de miliarde de ori. Modelul primește o bucată de text și trebuie să ghicească tokenul următor. De exemplu:
„Cine se scoală de dimineață, departe…”
Modelul dă, ca de obicei, o probabilitate fiecărei continuări: „ajunge” poate primi 40%, „merge” 10%, iar „ciorbă” o șansă foarte mică. Apoi i se arată ce scria de fapt în text: „ajunge”. Dacă modelul a dat o probabilitate mare variantei corecte, greșeala e mică. Dacă ar fi pariat sigur pe „ciorbă”, greșeala ar fi mare. Această măsură a greșelii se numește loss.
Un detaliu face totul posibil: nu e nevoie de oameni care să pregătească răspunsurile corecte. Textul însuși le conține. Orice frază de pe internet e, în același timp, și întrebare, și răspuns. De aceea această etapă poate folosi mii de miliarde de exemple: nimeni nu trebuie să le corecteze de mână.
Cum se reglează butoanele
După fiecare lot de exemple, un algoritm numit backpropagation calculează cât a contribuit fiecare buton la greșeală. Apoi fiecare buton e mișcat foarte puțin, în direcția care ar fi micșorat greșeala.
O comparație des folosită: imaginează-ți că ești legat la ochi pe un munte și vrei să ajungi în vale. Nu vezi nimic. Poți doar să simți panta sub tălpi și să faci un pas mic în direcția în care coboară terenul. Apoi încă unul. Și încă unul. Pașii sunt mici intenționat: dacă ai face salturi mari, ai putea sări peste vale.
Un singur pas nu învață modelul aproape nimic. Iar modelul nu primește nicio explicație, niciun „ai fost aproape”: doar varianta corectă și o măsură a greșelii, din care algoritmul calculează în ce parte să miște fiecare buton. Repetat însă pe mii de miliarde de tokeni, pe texte despre orice subiect imaginabil, acest proces de „ghicește, măsoară greșeala, ajustează puțin” produce ceva ce nimeni nu a programat explicit.
De ce iese de aici „cunoaștere”
Ca să ghicești bine continuarea unui text despre chimie, trebuie să „știi” chimie. Ca să completezi corect un cod de programare, trebuie să „înțelegi” ce face codul. Dacă modelul vede o funcție numită calculeaza_media care începe cu „total = suma numerelor” și se termină cu „return total /”, singura continuare bună e „numărul de elemente”. Ca s-o nimerească de fiecare dată, pe milioane de exemple diferite, modelului îi e mai „ieftin” să învețe ce înseamnă o medie decât să memoreze fiecare caz.
Așa apar, treptat, capacități pe care nu le-a programat nimeni: gramatica, apoi expresiile, apoi relațiile logice, traducerea, rezolvarea unor probleme de matematică, scrierea de cod. Unele dintre ele par să apară abia după ce modelul depășește o anumită mărime. Cercetătorii le numesc abilități emergente. Există și o dezbatere aici: unele studii arată că multe dintre aceste abilități nu apar brusc, cum părea inițial, ci cresc treptat și doar felul în care le măsurăm le face să pară salturi. Ideea de bază rămâne însă aceeași: capacitățile modelului vin din presiunea de a prezice bine, nu din reguli scrise de cineva.
Datele nu intră oricum
Textul brut de pe internet e plin de spam, pagini duplicate, conținut de calitate slabă sau toxic. Înainte de antrenare, totul trece prin filtre. În domeniu circulă o vorbă: „gunoi la intrare, gunoi la ieșire”. Modelul poate învăța doar ce există în datele lui, iar oamenii care decid ce rămâne și ce se aruncă îi modelează, discret, felul de a fi.
Tot aici se decide și proporția între subiecte și limbi. În cazul Llama 3, de pildă, Meta a declarat că aproximativ jumătate din date sunt cunoștințe generale, un sfert matematică și raționament, 17% cod, iar toate limbile în afară de engleză la un loc reprezintă doar în jur de 8%. Vom reveni la acest detaliu când vorbim despre română.
Cât costă
Volumul de calcul e greu de cuprins cu mintea. Să facem un exercițiu: să zicem că ai putea face un miliard de adunări și înmulțiri pe secundă. Cât ți-ar lua să faci singur toate calculele din antrenarea celui mai mare model Llama 3? Peste un miliard de ani.
În realitate, calculele sunt împărțite între mii sau chiar zeci de mii de procesoare grafice specializate, care lucrează în paralel luni de zile. Pentru cel mai mare model Llama 3, Meta a folosit până la 16.000 de astfel de procesoare. Sam Altman, directorul OpenAI, a spus în 2023 că antrenarea GPT-4 a costat mai mult de 100 de milioane de dolari. Cifrele oficiale exacte nu sunt publice, iar pentru modelele mai noi estimările și declarațiile conducătorilor din industrie vorbesc de sume și mai mari. Ordinul de mărime explică de ce doar câteva firme din lume își permit să antreneze modele de vârf.
Informaticianul Rich Sutton a numit acest fenomen „lecția amară” a inteligenței artificiale: de-a lungul deceniilor, metodele simple, aplicate cu tot mai multe date și tot mai multă putere de calcul, au învins aproape mereu metodele ingenioase construite de mână. Algoritmul de bază al antrenării e aproape jenant de simplu. Ce îl face să funcționeze e scara la care e aplicat.
Etapa 2: din ghicitor de text, asistent
La finalul preantrenării ai un model care cunoaște foarte bine limbajul și știe o mulțime de lucruri despre lume. Dar încă nu e un asistent. Dacă îl întrebi „Care e capitala Franței?”, un astfel de model brut poate continua cu „Care e capitala Germaniei? Care e capitala Italiei?”, pentru că așa arată multe teste de pe internet. Sau poate continua întrebarea ca pe un scenariu de film, ori ca pe o ceartă de pe o rețea socială. Pentru el, toate sunt continuări plauzibile.
Un chatbot e, de fapt, un scenariu de dialog: textul arată ca o conversație între un om și un asistent, iar modelul completează replicile asistentului. Ca să le completeze util, sigur și politicos, modelul trece printr-o a doua etapă de antrenare, numită postantrenare. Ea are de obicei două părți.
Exemple scrise de oameni
Prima parte se numește fine-tuning supervizat. Oameni angajați pentru asta scriu mii de exemple de dialog model: o întrebare și răspunsul ideal. „Rezumă acest paragraf”, urmat de un rezumat bun. „Rescrie acest e-mail mai politicos”, urmat de varianta rescrisă. Modelul e antrenat pe aceste exemple cu același mecanism ca înainte și învață formatul și tonul unui asistent.
Această etapă pune o „podea”: modelul ajunge cel puțin competent. Dar are o limită. În general, modelul nu ajunge mult mai bun decât exemplele pe care le-a văzut.
Oamenii compară răspunsuri
A doua parte e cea pe care oamenii o au în minte când spun că un AI „e recompensat”. Se numește RLHF, prescurtarea din engleză pentru învățare prin recompensă din feedback uman.
Modelul generează mai multe răspunsuri la aceeași întrebare, iar evaluatorii umani le compară și le ordonează. Să zicem că întrebarea e „Cum îmi răcesc laptopul care se supraîncălzește?”. Răspunsul A spune: „Curăță praful din fantele de aerisire, verifică ventilatorul și nu ține laptopul pe pătură.” Răspunsul B spune: „Pune-l într-o baie cu gheață.” Tehnic, ambele ar răci laptopul. Dar evaluatorul alege, evident, varianta A.
Din zeci de mii de astfel de comparații se antrenează un al doilea model, un fel de „notator automat”, care învață să ghicească ce răspuns ar prefera un om. Apoi modelul principal produce noi răspunsuri, notatorul le dă note, iar un algoritm ajustează butoanele modelului astfel încât răspunsurile cu note mari să devină mai probabile.
Efectul celor două etape la un loc e mare. În studiul din 2022 în care OpenAI le-a aplicat la GPT-3, evaluatorii au preferat răspunsurile unui model de 1,3 miliarde de parametri trecut prin ambele în fața celor ale GPT-3 obișnuit, de peste 100 de ori mai mare. Dacă fine-tuning-ul pune podeaua, această etapă ridică tavanul: modelul poate găsi răspunsuri mai bune decât cele din exemplele scrise de oameni.
Note date fără oameni
Rețetele s-au diversificat între timp. Anthropic, firma care dezvoltă Claude, a propus în 2022 o metodă numită „Constitutional AI”: o parte din comparații le face un alt model AI, ghidat de o listă de principii scrise. Unele firme antrenează modelele direct pe perechi de răspunsuri „ales” și „respins”, fără notator separat.
Iar acolo unde răspunsul se poate verifica automat, nici nu mai e nevoie de opinii. La o problemă de matematică, rezultatul e corect sau nu. Un program se poate rula pe un set de teste: trece sau nu trece. Modelele de azi fac un număr uriaș de astfel de exerciții, iar acest tip de antrenare stă la baza modelelor care „gândesc” înainte să răspundă, despre care vom vorbi într-un articol separat. Pentru un eseu despre politică externă, în schimb, nu există un test automat. Acolo rămân necesare judecata oamenilor sau a altor modele.
Un mit: modelul nu primește nicio „bomboană”
Cuvântul „recompensă” poate induce în eroare. Modelul nu simte satisfacție când primește o notă bună și nici dezamăgire când primește una proastă. Nici măcar nu știe că a fost notat. „Recompensa” e doar un număr folosit de programul de antrenare ca să decidă în ce direcție să miște butoanele. Termostatul nu „se bucură” când oprește centrala la temperatura dorită, iar modelul nu „se bucură” de o notă bună.
Când nota devine scopul
Antrenarea are o slăbiciune ascunsă. Modelul învață să obțină note mari, iar nota e doar o aproximare a ceea ce vrem de fapt. Când cele două se despart, modelul urmează nota. Fenomenul se numește reward hacking, adică „păcălirea recompensei”.
Un exemplu celebru vine dintr-un experiment OpenAI și DeepMind din 2017. Un braț robotic simulat trebuia să învețe să apuce obiecte, iar oamenii îi dădeau note privind imaginile de pe o cameră video. Robotul a învățat să își poziționeze mâna între cameră și obiect, astfel încât pe ecran părea că l-a apucat. Robotul nu era „șiret”. Pur și simplu găsise cea mai ușoară cale spre o notă mare.
La modelele de limbaj, același mecanism produce efecte mai subtile:
- Răspunsuri lungi și sigure pe ele. Dacă evaluatorii preferă, chiar și fără să-și dea seama, răspunsurile ample și categorice, modelul învață să le producă și atunci când un răspuns scurt, cu o doză de îndoială, ar fi mai onest.
- Prea multă amabilitate. Oamenilor le place să li se dea dreptate. Un model antrenat pe preferințele lor poate deveni lingușitor. În aprilie 2025, OpenAI a retras după doar câteva zile o actualizare a ChatGPT, recunoscând că modelul devenise „excesiv de flatant și de agreabil”. Explicația firmei: pusese prea mult accent pe reacțiile imediate ale utilizatorilor, de tipul „like” sau „dislike”.
- Scurtături la programare. Un model care scrie cod și e notat după teste incomplete poate învăța să treacă testele fără să rezolve cu adevărat problema.
Firmele combat aceste efecte cu exemple mai bune, cu mai multe tipuri de note în paralel și cu teste independente. Dar nu există un notator perfect pentru adevăr, utilitate sau bun-simț.
De ce modelul are o „dată de expirare”
Când antrenarea se termină, butoanele modelului sunt înghețate. Din acel moment, modelul nu mai învață nimic. Fiecare răspuns pe care îl dă, timp de luni sau ani, folosește exact aceiași parametri. Momentul până la care merg datele lui de antrenare se numește dată-limită a cunoștințelor (în engleză, „knowledge cutoff”).
Între această dată și momentul în care folosești modelul trec de obicei multe luni: antrenarea, verificările și lansarea durează, iar apoi modelul rămâne în uz încă mult timp. De aceea un asistent poate să nu știe cine a câștigat ultimele alegeri, ce lege nouă a apărut sau cum s-a terminat un meci de săptămâna trecută. Poate nici să nu știe ce dată e azi, dacă aplicația nu i-o spune.
Asistenții care pot căuta pe internet compensează în parte această problemă. Dar atenție la ce se întâmplă de fapt: modelul nu „află” lucrurile noi în sensul în care le-a învățat pe cele vechi. Citește rezultatele căutării ca pe orice alt text primit în conversație și le folosește doar pentru răspunsul de atunci. Dacă rezultatele sunt slabe sau greșite, și răspunsul va fi.
Nu învață din conversația ta
Din același motiv, modelul nu se schimbă când îl corectezi. Corectura contează doar în conversația curentă, pentru că face parte din textul pe care îl citește. Într-o conversație nouă, aceeași greșeală poate apărea din nou. Funcțiile de „memorie” din unele aplicații nu schimbă modelul: păstrează niște notițe despre tine pe care aplicația i le pune în față la începutul fiecărei conversații.
O distincție importantă: faptul că modelul nu învață pe loc din ce îi scrii nu înseamnă că ce îi scrii nu poate fi folosit mai târziu. În funcție de serviciu și de setările contului tău, conversațiile pot fi folosite la antrenarea versiunilor viitoare.
De ce româna pornește în dezavantaj
Am văzut în primul articol că româna „costă” mai mulți tokeni decât engleza. Problema e însă mai profundă și ține de date.
Un studiu publicat în noiembrie 2025 de cercetători de la Universitatea Națională de Știință și Tehnologie Politehnica București (Vlad Negoiță, Mihai Masala și Traian Rebedea) a analizat textele românești disponibile pentru antrenarea modelelor. Concluziile lor:
- Româna e subreprezentată în marile colecții de texte multilingve. De aceea, modelele antrenate mai ales pe engleză se descurcă mai slab în română.
- Există doar trei colecții mari de texte în română, toate extrase din aceeași arhivă a internetului. Cea mai mare are în jur de 150 de miliarde de tokeni. O colecție similară în engleză are 15.000 de miliarde, adică de circa o sută de ori mai mult.
- Textul de calitate e puțin. Peste 80% din textul românesc de pe web are o valoare educativă de nivel primar sau gimnazial, iar doar aproximativ 1% depășește nivelul de liceu. Dacă păstrezi doar textele cu valoare educativă ridicată, rămân câteva miliarde de tokeni.
- Subiectele sunt dezechilibrate. Comparat cu cel englezesc, web-ul românesc are proporțional mai mult despre finanțe și afaceri, sănătate și politică, dar clar mai puțin despre știință, matematică și tehnologie.
Autorii au arătat și că situația se poate îmbunătăți: un model antrenat în continuare pe texte românești atent filtrate a obținut rezultate mai bune la teste în română. Experimentul a fost făcut pe un model relativ mic (7 miliarde de parametri), deci arată o direcție, nu măsoară performanța asistenților comerciali de azi.
Pentru tine, ca utilizator, asta are o consecință practică. Un model „știe” bine lucrurile despre care s-a scris mult. Întreabă-l despre Eminescu sau despre Revoluția din 1989 și va avea de unde să răspundă. Întreabă-l despre istoria unei comune mici, despre un scriitor local sau despre o hotărâre a unui consiliu județean și va avea foarte puțin material. Dar modelul nu se oprește când nu știe: produce tot un răspuns plauzibil. Exact aici apar cele mai multe invenții.
Controversele: al cui e textul?
Drepturile de autor
Modelele au fost antrenate pe texte scrise de oameni care nu au fost întrebați și, de cele mai multe ori, nici plătiți. Mai mulți autori și editori au dus subiectul în instanță.
Cel mai cunoscut proces e cel deschis de New York Times împotriva OpenAI și Microsoft, în decembrie 2023. Ziarul acuză că milioane de articole ale sale au fost folosite fără permisiune. La începutul lui noiembrie 2026, procesul era încă în faza pregătitoare, fără o decizie asupra fondului. Alte instanțe s-au pronunțat însă deja în cazuri asemănătoare, și nu toate în același sens.
Un alt caz s-a încheiat deja. Un grup de autori a dat în judecată Anthropic, firma care dezvoltă Claude. În iunie 2025, un judecător american a decis că antrenarea modelului pe cărți intră în categoria „utilizării echitabile” (fair use) permise de legea americană, dar că păstrarea unei biblioteci de cărți piratate descărcate de pe internet nu intră. Anthropic a acceptat apoi o înțelegere de 1,5 miliarde de dolari, aproximativ 3.000 de dolari pentru fiecare dintre cele circa 500.000 de cărți vizate. Instanța a aprobat definitiv înțelegerea în iulie 2026. Avocații autorilor au descris-o drept cea mai mare despăgubire pentru drepturi de autor din istoria Statelor Unite. Firma nu și-a recunoscut vina.
În Uniunea Europeană regulile sunt diferite. Folosirea textelor publice pentru extragere automată de date e permisă, dacă autorul sau site-ul nu s-a opus explicit. Din august 2025, Regulamentul european privind inteligența artificială obligă firmele care oferă modele de uz general să respecte aceste opoziții și să publice un rezumat al datelor pe care le-au folosit la antrenare. Instanțele europene au început și ele să se pronunțe: în noiembrie 2025, un tribunal din München a decis, într-un proces deschis de GEMA, organizația germană a autorilor de muzică, că OpenAI a încălcat drepturile de autor, pentru că modelul memorase versuri de cântece și le putea reproduce. Decizia nu e încă definitivă.
Cine controlează datele controlează răspunsurile
Pentru că modelul învață din ce citește, datele de antrenare pot fi și o țintă. Un studiu din 2025 al Anthropic, realizat împreună cu Institutul britanic pentru Securitatea AI și Institutul Alan Turing, a arătat că aproximativ 250 de documente „otrăvite”, strecurate printre sute de milioane de documente normale, au fost suficiente ca să ascundă într-un model un comportament declanșat de o anumită expresie. Rezultatul a fost același indiferent de mărimea modelului. Comportamentul testat a fost unul inofensiv, iar autorii avertizează că nu se știe dacă rezultatul se menține la modelele cele mai mari. Mesajul rămâne însă: câteva documente bine plasate pot conta mult.
Influența poate veni și din partea celor care antrenează modelul. Modelele chinezești, precum DeepSeek, ocolesc sau dau răspunsuri evazive la întrebări despre subiecte sensibile pentru guvernul chinez, cum ar fi reprimarea din Piața Tiananmen din 1989. Testele independente arată că nu e un accident al datelor, ci o alegere făcută la postantrenare și prin filtre, în acord cu regulile chinezești, care cer serviciilor de AI să respecte „valorile socialiste fundamentale”. Și firmele occidentale aleg ce refuză modelele lor, chiar dacă nu la cererea unui guvern. Cazul arată cât de mult contează cine antrenează un model și după ce reguli.
Ce înseamnă asta pentru tine: patru lucruri utile
1. Verifică informațiile recente
Orice s-a întâmplat după data-limită a modelului îi e necunoscut, iar el nu știe mereu că nu știe. Pentru știri, prețuri, legi sau orice se schimbă des, folosește un asistent care caută pe internet și uită-te la sursele pe care le arată.
2. Fii atent la ce scrii
Ce trimiți unui asistent AI poate ajunge, în funcție de setări, în datele de antrenare ale versiunilor viitoare. Uită-te în setările contului tău la opțiunea despre folosirea conversațiilor pentru antrenare și nu introduce date personale, parole sau informații confidențiale de la serviciu.
3. Fii și mai atent la subiectele românești și locale
Cu cât s-a scris mai puțin despre un subiect, mai ales în română, cu atât crește riscul ca modelul să umple golurile cu invenții plauzibile. Nume de oameni, date, cifre și istorii locale merită verificate de două ori.
4. Nu te lăsa flatat
Modelele sunt antrenate, printre altele, să le placă oamenilor. Dacă un asistent îți dă dreptate prea ușor, cere-i explicit să-ți arate punctele slabe ale ideii tale sau argumentele părții opuse. Vei primi de obicei un răspuns mai util decât o confirmare.
Pe scurt
Un model AI începe ca o masă de mixaj cu miliarde de butoane puse la întâmplare. În preantrenare citește mii de miliarde de tokeni și joacă la nesfârșit același joc: ghicește următorul cuvânt, vede cât a greșit, își ajustează puțin butoanele. Din acest exercițiu simplu, repetat la o scară uriașă, apar limbajul, cunoștințele și abilitățile lui. În postantrenare, exemplele scrise de oameni și notele date de oameni sau de alte programe îl transformă din ghicitor de text în asistent. Apoi butoanele sunt înghețate, iar modelul rămâne cu ce a învățat până la data lui limită.
Toate acestea explică de ce un asistent AI știe atât de multe, dar și de ce greșește, de ce e uneori prea amabil, de ce nu știe ultimele știri și de ce se descurcă mai slab cu subiectele românești.
În articolul următor: modelele care „gândesc” înainte să răspundă. Ce se întâmplă în acele secunde de „gândire”, de ce ajută la matematică și programare și când nu ajută deloc.
Surse
- Meta, „The Llama 3 Herd of Models” (2024), despre datele de antrenare, compoziția lor și infrastructura folosită: arxiv.org/abs/2407.21783
- Brown și colaboratorii, „Language Models are Few-Shot Learners” (2020), lucrarea GPT-3: arxiv.org/abs/2005.14165
- Ouyang și colaboratorii, „Training language models to follow instructions with human feedback” (2022), lucrarea OpenAI despre RLHF: arxiv.org/abs/2203.02155
- Bai și colaboratorii, „Constitutional AI: Harmlessness from AI Feedback” (2022), Anthropic: arxiv.org/abs/2212.08073
- Wei și colaboratorii, „Emergent Abilities of Large Language Models” (2022): arxiv.org/abs/2206.07682; Schaeffer și colaboratorii, „Are Emergent Abilities of Large Language Models a Mirage?” (2023): arxiv.org/abs/2304.15004
- Rich Sutton, „The Bitter Lesson” (2019): incompleteideas.net/IncIdeas/BitterLesson.html
- Christiano și colaboratorii, „Deep Reinforcement Learning from Human Preferences” (2017), OpenAI și DeepMind: arxiv.org/abs/1706.03741; exemplul brațului robotic e descris în postarea OpenAI „Learning from human preferences” (13 iunie 2017): openai.com/index/learning-from-human-preferences
- OpenAI, „Sycophancy in GPT-4o: what happened and what we're doing about it” (aprilie 2025): openai.com/index/sycophancy-in-gpt-4o
- Negoiță, Masala și Rebedea (UNSTPB), „Improving Romanian LLM Pretraining Data using Diversity and Quality Filtering” (noiembrie 2025): arxiv.org/abs/2511.01090
- Souly și colaboratorii, „Poisoning Attacks on LLMs Require a Near-Constant Number of Poison Samples” (2025), Anthropic, UK AI Security Institute și Alan Turing Institute: arxiv.org/abs/2510.07192
- Wired, „OpenAI's CEO Says the Age of Giant AI Models Is Already Over” (aprilie 2023), cu declarația despre costul GPT-4
- Bartz v. Anthropic PBC, cazul nr. 4:24-cv-05417 (N.D. California), aprobarea finală a înțelegerii pe 20 iulie 2026
- Tribunalul Regional München I, GEMA contra OpenAI, dosarul 42 O 14139/24, hotărârea din 11 noiembrie 2025
- Directiva (UE) 2019/790, art. 4, și Regulamentul (UE) 2024/1689 privind inteligența artificială, art. 53