Pui o întrebare mai grea unui asistent AI și, în loc să înceapă imediat să scrie, pe ecran apare „Se gândește…”. Trec câteva secunde, uneori un minut întreg. Apoi vine răspunsul, de multe ori mai bun decât al unui model obișnuit. Uneori poți desface și o casetă în care vezi ce a „gândit”: încercări, calcule, ezitări, chiar și un „stai puțin, am greșit”.
Aceste modele se numesc modele care raționează (în engleză, „reasoning models” sau „thinking models”). Primul cunoscut publicului larg a fost o1, prezentat de OpenAI în septembrie 2024, întâi într-o versiune de previzualizare. În ianuarie 2025, firma chineză DeepSeek a lansat R1, un model pe care oricine îl poate descărca gratuit și care, după testele publicate de firmă, se apropia de o1. DeepSeek a publicat și metoda prin care l-a antrenat, deși nu și datele folosite. Astăzi, aproape toți marii asistenți, de la ChatGPT la Claude și Gemini, au un astfel de mod.
În primele două articole din serie am văzut cum generează un model textul, token cu token, și cum e antrenat. Acum vedem ce se întâmplă în acele secunde de „gândire”, de ce ajută și când nu ajută deloc.
Ideea centrală: și „gândirea” e tot text
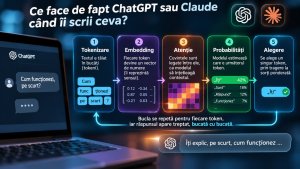
O explicație des întâlnită spune că aceste modele își fac întâi un plan „în minte” și abia apoi încep să scrie. Nu e chiar așa. Un model care raționează folosește exact același mecanism ca orice model de limbaj: alege câte un token, îl adaugă la text și o ia de la capăt. Diferența e că, înainte de răspunsul pentru tine, scrie un text pentru el însuși: o ciornă.
Gândește-te la o lucrare scrisă de la școală. Pe ciornă faci calculele, tai, încerci altă metodă, verifici. Pe foaia de teză copiezi doar rezolvarea curată. Modelul face la fel: scrie întâi ciorna, adesea lungă de sute, mii, uneori zeci de mii de tokeni, apoi răspunsul final. „Gândirea” lui e acea ciornă.
Dacă e doar text, de ce ar ajuta? Răspunsul ține de felul în care lucrează modelul pe dinăuntru.
De ce ajută să scrii pașii
Am văzut în primul articol că, pentru fiecare token, textul trece o dată prin toate straturile modelului. Cantitatea de calcul pentru un token e, în mare, mereu aceeași. Dacă modelul trebuie să dea răspunsul la o problemă cu mai mulți pași dintr-un singur token, toată problema trebuie rezolvată într-o singură trecere prin rețea. Uneori iese, alteori nu.
Când modelul scrie pașii, fiecare pas înseamnă alți tokeni, deci alte treceri prin rețea, deci mai mult calcul. În plus, rezultatele intermediare ajung în text, iar mecanismul de atenție le poate „vedea” la pașii următori. E diferența dintre a înmulți 347 cu 28 în minte și a face înmulțirea pe hârtie.
Efectul a fost descris într-un studiu Google din 2022. Cercetătorii au dat unui model foarte mare probleme de matematică cu enunț, de nivelul școlii primare, de tipul: „La cantină erau 23 de mere. Au folosit 20 ca să facă prânzul și au mai cumpărat 6. Câte mere mai au?” Când modelul trebuia să dea direct rezultatul, a răspuns 27. Când i s-au arătat câteva exemple rezolvate pas cu pas, a scris și el pașii („au rămas 23 − 20 = 3 mere, apoi 3 + 6 = 9”) și a ajuns corect la 9. Autorii au numit tehnica chain of thought, adică „lanț de gânduri”. Efectul apărea însă doar la modelele foarte mari: cele mici scriau pași fără sens.
Câteva luni mai târziu, un alt studiu a arătat că nici exemplele nu sunt necesare. Era suficient ca răspunsul modelului să înceapă cu fraza „Let's think step by step” („Hai să ne gândim pas cu pas”). La un test cu probleme de aritmetică, scorul a sărit de la 18% la 79%. Așa a apărut o întreagă colecție de „formule magice” pentru prompturi. Modelele care raționează au făcut ca multe dintre ele să nu mai fie necesare: modelul scrie pașii din proprie inițiativă.
O idee nouă: mai mult calcul în momentul răspunsului
Până în 2024, rețeta pentru modele mai bune era cea din articolul trecut: modele mai mari, antrenate pe mai multe date, cu mai multă putere de calcul. Exista însă și o altă cale: să investești calcul în celălalt moment, atunci când modelul îți răspunde. Ideea nu era complet nouă, primele metode de mai jos datează din 2022 și 2023, dar în 2024 a devenit direcția principală. Are și un nume tehnic: test-time compute, adică putere de calcul folosită la răspuns.
Cea mai simplă variantă: mai multe încercări și vot
Cel mai simplu mod de a folosi mai mult calcul e să pui aceeași întrebare de mai multe ori. Am văzut în primul articol că modelul alege tokenii prin tragere la sorți ponderată, deci răspunsurile ies ușor diferite. Generezi, să zicem, 100 de răspunsuri și îl alegi pe cel care apare cel mai des. Metoda funcționează: un răspuns corect tinde să fie găsit pe mai multe drumuri, iar greșelile se împrăștie.
Are însă o limită. Dacă modelul face aceeași greșeală de fiecare dată, votul nu ajută. E ca atunci când ai inversat borcanele de sare și zahăr din bucătărie: poți face prăjitura de o sută de ori, tot sărată iese.
O variantă mai bună folosește un al doilea model, un fel de „corector”, care dă o notă fiecărui răspuns. Unii corectori notează chiar fiecare pas al raționamentului, nu doar rezultatul final, pentru că un raționament poate ajunge din noroc la răspunsul corect pe un drum greșit.
Pentru o1, OpenAI a publicat rezultatele la AIME, un concurs american de matematică pentru liceeni care face parte din selecția pentru olimpiadă. Un test are 15 probleme, iar răspunsurile sunt numere întregi, deci se pot verifica automat. GPT-4o, un model obișnuit, rezolva în medie 12% din probleme. o1 rezolva 74% din prima încercare, datorită antrenării despre care vorbim mai jos. Cu vot între 64 de încercări urca la 83%, iar cu un corector automat care alegea dintre 1.000 de răspunsuri, la 93%.
Cum învață un model să gândească
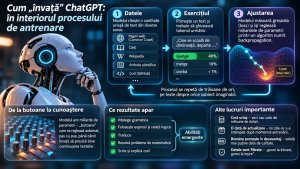
Votul și corectorii folosesc un model deja antrenat. Modelele care raționează merg însă mai departe: sunt antrenate să scrie ciorne lungi și utile. Metoda e cea din articolul trecut, de la secțiunea despre notele date fără oameni: învățarea prin recompensă pe probleme cu răspuns verificabil. Modelul primește o problemă de matematică sau de programare, scrie o ciornă și un răspuns, iar un program verifică doar dacă rezultatul final e corect. Drumurile care au dus la răspunsuri corecte devin mai probabile.
Lucrarea DeepSeek despre R1, publicată în ianuarie 2025 și apoi, după ce a fost verificată de alți cercetători, în revista Nature, arată ce se întâmplă în timpul acestei antrenări. Pentru o primă versiune, numită R1-Zero, cercetătorii nu i-au dat modelului niciun exemplu de raționament scris de oameni. I-au spus doar să-și pună gândurile între două etichete, apoi să dea răspunsul, și l-au notat după corectitudinea rezultatului și după respectarea acestui format. La concursul AIME, scorul a crescut de la 15,6% la începutul antrenării la aproape 78%, potrivit versiunii publicate în Nature.
Două lucruri s-au accentuat fără să le fi cerut cineva. Primul: ciornele au devenit tot mai lungi. Ciornele lungi duceau mai des la note bune, iar antrenarea le-a făcut tot mai frecvente. Al doilea: modelul a început să se oprească și să se verifice. Cercetătorii au surprins un moment în care modelul a scris, în mijlocul unei rezolvări: „Stai, stai. Stai. Ăsta e un moment «aha» pe care îl pot semnala aici.”, apoi a reluat verificarea pas cu pas. Formularea pare omenească, dar mecanismul nu e: antrenarea a făcut astfel de reveniri mai probabile, pentru că ciornele care le conțineau ajungeau mai des la răspunsul corect. Alți cercetători au arătat ulterior că astfel de reveniri existau, mai rar, și în modelul de dinainte, iar o parte din lungirea ciornelor ținea de algoritmul de antrenare. Antrenarea le-a întărit, nu le-a inventat de la zero.
Rețeta folosită în practică
R1-Zero avea și defecte: ciornele erau greu de citit și amestecau limbile. Versiunea finală, R1, a pornit de la câteva mii de exemple de raționament bine scris, învățate prin fine-tuning, și abia apoi a trecut prin învățarea prin recompensă, în mai multe runde. Combinația a fost preluată de multe modele publicate de atunci. Un studiu din 2025, făcut pe un joc de cărți cu calcule și pe o sarcină de orientare, a găsit că fine-tuning-ul tinde să memoreze exemplele, iar învățarea prin recompensă se descurcă mai bine cu variante noi, pe care modelul nu le-a mai văzut. A găsit însă și că fine-tuning-ul rămâne util înainte, pentru că îl obișnuiește pe model cu forma răspunsului.
O altă tehnică importantă se numește distilare. Un model mare care raționează bine generează sute de mii de rezolvări (în cazul DeepSeek, circa 800.000 de exemple), iar un model mic e antrenat pe ele. DeepSeek a publicat astfel și modele mici, dintre care cele mai mici pot rula pe un calculator personal performant, iar acestea au rămas surprinzător de bune la matematică.
Și costurile spun ceva. DeepSeek a estimat că etapele care au transformat modelul de bază în R1 au cerut circa 147.000 de ore de lucru ale unor plăci grafice, adică aproximativ 294.000 de dolari la prețul de închiriere. Cifra nu include costul modelului de bază, estimat de firmă la câteva milioane de dolari, nici experimentele anterioare, și nu a fost verificată independent. Dar arată că, odată ce ai un model bun, învățarea raționamentului nu mai cere neapărat sute de milioane de dolari.
Ce vezi și ce nu vezi din „gândire”
Nu toate firmele îți arată ciorna. Când a lansat o1, OpenAI a decis să nu le arate utilizatorilor raționamentul brut, ci doar un rezumat. Multe alte aplicații afișează și ele un rezumat al ciornei, nu textul complet. DeepSeek R1, în schimb, a arătat de la început întreaga ciornă.
De ce poate „gândi” în engleză
Un detaliu interesant pentru cititorii români: dacă scrii în română, s-ar putea ca raționamentul să fie, parțial sau integral, în engleză. Lucrarea DeepSeek o spune deschis: modelul a fost optimizat pentru chineză și engleză și poate folosi engleza pentru raționament chiar dacă întrebarea e în altă limbă. În timpul antrenării, ciornele amestecau limbile, așa că cercetătorii au adăugat o notă suplimentară pentru folosirea consecventă a limbii cerute. Au observat că asta scade ușor performanța. Autorii pun problema pe seama modelului de bază, antrenat mai ales pe texte în chineză și engleză. Se leagă și de ce am văzut în articolul trecut: româna are de circa o sută de ori mai puține texte disponibile decât engleza.
Ciorna spune adevărul?
E tentant să crezi că ciorna e o fereastră directă spre „mintea” modelului. Un studiu Anthropic din 2025 arată că nu întotdeauna. Cercetătorii au strecurat în întrebări indicii despre răspuns, apoi au verificat dacă modelele, atunci când foloseau indiciul, recunoșteau asta în raționament. Claude 3.7 Sonnet, chiar modelul firmei, l-a menționat în doar 25% din cazuri, iar DeepSeek R1 în 39%. În rest, ciorna nu pomenea indiciul, deși răspunsul fusese influențat de el, iar de multe ori construia chiar o justificare aparent independentă.
Asta nu înseamnă că ciorna e inutilă. De multe ori chiar arată drumul real al rezolvării și te ajută să vezi unde a greșit modelul. Dar nu e o garanție. Ne amintim din primul articol că starea internă a modelului poate anticipa lucruri pe care textul nu le spune încă. Ciorna e tot un text produs de model, nu o înregistrare a calculelor lui.
Când ajută și când nu
Modelele care raționează sunt clar mai bune la sarcinile cu mulți pași: probleme de matematică, programare, logică, planificare, analiza unor date sau a unui document lung din care trebuie trase concluzii. La testele grele de matematică și programare, primele locuri sunt ocupate astăzi aproape numai de modele care raționează.
Pentru alte sarcini, „gândirea” aduce puțin:
- Întrebări simple. Ca să afli capitala Portugaliei sau sinonimul unui cuvânt, ciorna doar te face să aștepți. Chiar și autorii DeepSeek recunosc că modelul lor „gândește” uneori prea mult la întrebări simple.
- Fapte pe care modelul nu le știe. Oricât ar raționa, modelul nu poate deduce o informație care nu era în datele lui de antrenare sau în conversație. În cel mai bun caz, recunoaște că nu știe. În cel mai rău, construiește un raționament convingător spre un răspuns inventat.
- Texte scurte și creative. La o urare, o postare sau un e-mail scurt, ciorna aduce de obicei puțin: nu există un răspuns „corect” pe care să-l poată verifica.
Un studiu Apple din 2025 a testat modelele pe puzzle-uri a căror dificultate putea fi crescută treptat. Rezultatele au arătat trei zone: la probleme simple, modelele obișnuite s-au descurcat mai bine decât cele care raționează, cu aceeași putere de calcul; la cele de dificultate medie, modelele care raționează au câștigat clar; iar la cele foarte grele, ambele tipuri au eșuat complet. Mai mult, aproape de punctul de eșec, modelele „gândeau” mai puțin, nu mai mult. Studiul a fost contestat. Un răspuns publicat la scurt timp a arătat că unele puzzle-uri cereau răspunsuri mai lungi decât limita permisă modelelor, iar unele variante ale problemei cu traversarea râului nu aveau, de fapt, soluție. Concluzia prudentă: raționamentul ajută mult, dar nu nelimitat.
Costul
Ciorna nu e gratuită. Fiecare token al ei trece prin model la fel ca un token din răspuns, deci consumă timp, energie și bani. Un răspuns care cere zeci de secunde de „gândire” poate costa de câteva ori, uneori de zeci de ori mai mult decât unul obișnuit. De aceea firmele oferă astfel de modele în mai multe variante, cu un buget de „gândire” mai mic sau mai mare, iar unele aplicații decid singure, după întrebare, cât să lase modelul să raționeze.
Ce înseamnă asta pentru tine: patru lucruri utile
1. Alege modul potrivit pentru sarcină
Pentru o problemă cu mai mulți pași, un calcul, scrierea unui program, o comparație între oferte sau un document complicat, merită să activezi modul de raționament și să aștepți. Pentru o întrebare rapidă, o traducere scurtă sau un text simplu, modul obișnuit e de obicei la fel de bun și mult mai rapid.
2. Nu mai ai nevoie de formule magice
Cu un model care raționează, nu mai e nevoie să scrii „gândește-te pas cu pas”. Mai util e să descrii clar problema, ce date ai, ce vrei să obții și în ce formă vrei răspunsul. Lucrarea DeepSeek observă chiar că, pentru R1, exemplele date în prompt au înrăutățit rezultatele, iar autorii recomandă descrierea directă a problemei.
3. Citește ciorna, dar nu o crede orbește
Dacă aplicația îți arată raționamentul, uită-te prin el: poți descoperi că modelul a înțeles greșit întrebarea sau a pornit de la o presupunere falsă. Dar nu lua ciorna drept dovadă. Un raționament care sună bine nu garantează un răspuns corect.
4. „Gândirea” nu înlocuiește verificarea
Un model care raționează greșește mai rar la logică și calcule, dar poate inventa în continuare fapte, nume și surse. Pentru informații care se pot verifica, sfatul din articolele trecute rămâne valabil: verifică numele, cifrele și sursele.
Pe scurt
Modelele care raționează nu au un organ separat de gândire. Ele scriu, cu același mecanism, token cu token, o ciornă înainte de răspuns. Ciorna le dă mai mult timp de calcul și un loc unde să păstreze rezultatele intermediare. Au învățat să scrie ciorne utile prin învățare prin recompensă, pe mii de probleme verificabile, iar în timpul antrenării ciornele s-au lungit și verificările au devenit tot mai frecvente. Rezultatul e un salt mare la matematică, programare și logică, plătit cu timp de așteptare și cost mai mare. Iar ciorna, oricât de convingătoare, nu e întotdeauna o descriere fidelă a felului în care modelul a ajuns la răspuns.
În articolul următor: ce primește modelul înaintea întrebării tale. Am pomenit pe scurt, în primul articol, instrucțiunile ascunse ale firmei. De data asta le luăm pe larg, împreună cu căutarea pe internet, memoria și uneltele: tot ce adaugă o aplicație peste modelul propriu-zis.
Surse
- Wei și colaboratorii, „Chain-of-Thought Prompting Elicits Reasoning in Large Language Models” (2022), cu exemplul merelor de la cantină: arxiv.org/abs/2201.11903
- Kojima și colaboratorii, „Large Language Models are Zero-Shot Reasoners” (2022), despre „Hai să ne gândim pas cu pas”: arxiv.org/abs/2205.11916
- Wang și colaboratorii, „Self-Consistency Improves Chain of Thought Reasoning in Language Models” (2022), despre votul între mai multe răspunsuri: arxiv.org/abs/2203.11171
- Lightman și colaboratorii, „Let's Verify Step by Step” (2023), OpenAI, despre corectorii care notează fiecare pas: arxiv.org/abs/2305.20050
- OpenAI, „Learning to Reason with LLMs” (septembrie 2024), lansarea o1 și rezultatele la AIME: openai.com/index/learning-to-reason-with-llms
- DeepSeek-AI, „DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning” (ianuarie 2025): arxiv.org/abs/2501.12948 (cifrele din articol sunt din versiunea revizuită); publicată în Nature, vol. 645 (2025): doi.org/10.1038/s41586-025-09422-z
- Liu și colaboratorii, „Understanding R1-Zero-Like Training: A Critical Perspective” (2025): arxiv.org/abs/2503.20783
- Chu și colaboratorii, „SFT Memorizes, RL Generalizes” (2025): arxiv.org/abs/2501.17161
- Chen și colaboratorii, „Reasoning Models Don't Always Say What They Think” (2025), Anthropic: arxiv.org/abs/2505.05410
- Shojaee și colaboratorii, „The Illusion of Thinking” (2025), Apple: arxiv.org/abs/2506.06941
- Lawsen, „Comment on The Illusion of Thinking” (2025), răspunsul critic la studiul Apple: arxiv.org/abs/2506.09250