Scrii o întrebare, apeși Enter, iar după o secundă textul începe să curgă pe ecran, cuvânt cu cuvânt. Răspunsul sună coerent, uneori surprinzător de omenesc. Milioane de oameni folosesc zilnic ChatGPT, Claude, Gemini sau Grok, dar puțini știu ce se întâmplă de fapt în acea secundă.
Nu e magie și nici un om ascuns în spatele ecranului. Nu e nici o bază de date uriașă din care se scoate răspunsul gata scris. E un mecanism, iar ideea de bază se poate înțelege fără matematică.
Acesta este primul articol dintr-o serie despre inteligența artificială pe înțelesul tuturor. Aici vedem pas cu pas ce se întâmplă din momentul în care trimiți un mesaj până când apare răspunsul. La final, vei înțelege și de ce aceste programe greșesc uneori cu atâta încredere.
Ideea centrală: un ghicitor de text extrem de bun
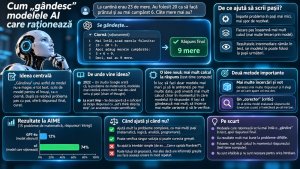
ChatGPT, Claude și celelalte sunt construite pe ceea ce se numește LLM, adică Large Language Model, sau „model lingvistic mare”. Un astfel de model face, în esență, un singur lucru: primește un text și estimează care e următoarea bucată de text.
Atât. Nu caută răspunsul într-o enciclopedie și nu compune întâi o frază întreagă în minte pe care apoi o copiază pe ecran. Alege o bucată mică de text, o adaugă la ce era scris, apoi alege următoarea bucată. Și tot așa, de sute sau mii de ori, până când răspunsul e complet.
De aceea vezi răspunsul apărând treptat. Nu e un efect vizual pus ca să arate frumos: chiar așa e generat textul, pe bucăți.
Poate părea prea simplu ca să explice ceva capabil să scrie un eseu, să traducă sau să programeze. Secretul stă în cât de bine face modelul această estimare. Ca să prezici corect continuarea unui text despre chimie, medicină sau programare, trebuie să „știi” destul de multe despre chimie, medicină sau programare.
Procesul are cinci pași, care se repetă pentru fiecare bucată de text. Îi luăm pe rând.
- Tokenizare: textul tău e tăiat în bucăți mici, numite tokeni.
- Embedding: fiecare token devine o listă de numere care îi reprezintă sensul.
- Atenție: cuvintele sunt legate între ele, ca modelul să înțeleagă contextul.
- Probabilități: fiecare continuare posibilă primește o notă.
- Alegere: se alege un singur token, prin tragere la sorți ponderată.
Cei cinci pași formează o buclă: după fiecare token ales, textul crește cu o bucată și procesul o ia de la capăt.
Pasul 1: textul tău e tăiat în bucăți
Modelul nu citește litere și nici cuvinte întregi. Citește tokeni: bucăți de text care pot fi un cuvânt întreg, o parte de cuvânt sau un semn de punctuație.
Cuvintele foarte des întâlnite primesc de obicei un singur token. Cuvintele rare sau lungi sunt sparte în mai multe bucăți. De exemplu, un cuvânt ca „neînțelegere” ar putea fi împărțit în ceva de genul „ne” + „înțeleg” + „ere”. Punctul de la final de propoziție e și el un token separat.
Împărțirea nu o decide modelul pe loc. Se face înainte, de un program separat numit tokenizer, care a învățat din foarte mult text care sunt bucățile cele mai eficiente. Fiecare bucată are un număr de identificare, ca într-un dicționar. Un model modern are un vocabular de ordinul a 100.000 de astfel de tokeni.
Așa că propoziția ta ajunge în model nu ca text, ci ca un șir de numere: de exemplu, 7 numere pentru o propoziție scurtă.
De ce contează pentru cititorii români
Tokenizerele sunt antrenate în mare parte pe texte în engleză. De aceea, cuvintele englezești sunt de obicei „ieftine”: multe au un singur token. Româna, cu diacriticele și terminațiile ei gramaticale, se sparge adesea în mai multe bucăți.
În practică, asta înseamnă două lucruri:
- Același text în română ocupă de regulă mai mulți tokeni decât în engleză. Limitele de lungime ale modelelor se măsoară în tokeni, nu în cuvinte, deci în română ele se umplu mai repede.
- Costul poate fi mai mare. Firmele sau programatorii care folosesc aceste modele prin API plătesc per token. Un text românesc poate costa vizibil mai mult decât echivalentul lui în engleză.
Ca reper: în engleză, o mie de tokeni înseamnă cam 750 de cuvinte. În română, raportul e de obicei mai puțin avantajos.
Pasul 2: fiecare bucată primește un „loc pe hartă”
Un număr de identificare nu spune nimic despre sens. Numărul pentru „câine” nu are nicio legătură cu numărul pentru „cățel”. Așa că fiecare token e transformat într-un vector: o listă lungă de numere, de ordinul miilor. Această listă se numește embedding.
Cel mai ușor e să-ți imaginezi aceste numere drept coordonate pe o hartă imensă a sensurilor. Doar că harta nu are două dimensiuni, ca una obișnuită, ci mii. Cuvintele cu sensuri apropiate ajung să stea aproape unele de altele: „câine” lângă „cățel” și „pisică”, „București” lângă „Cluj” și „Iași”, „fericit” lângă „bucuros”.
Nimeni nu a așezat manual cuvintele pe această hartă. Pozițiile au fost învățate automat, din faptul că anumite cuvinte apar în contexte asemănătoare. Dacă „Python” și „JavaScript” apar mereu în fraze despre programare, ajung vecini.
Pentru curioși
Există o demonstrație celebră: dacă iei vectorul pentru „rege”, scazi „bărbat” și aduni „femeie”, ajungi aproape de „regină”. Ea vine de la modele mai vechi de embedding-uri, din 2013, și funcționează mai puțin curat decât sugerează exemplul. Dar ideea rămâne valabilă: pe această hartă, și relațiile dintre cuvinte capătă o formă geometrică.
Un detaliu important, pe care multe explicații îl sar: la acest pas, un cuvânt cu mai multe sensuri are o singură poziție. „Broască” are același vector indiferent dacă e vorba de animal sau de broasca ușii. Sensul corect se stabilește abia la pasul următor.
Pasul 3: contextul, prin mecanismul de atenție
Acum vectorii intră în „creierul” modelului: o rețea neuronală de tip Transformer, cu miliarde de parametri. Inventată în 2017, această arhitectură stă la baza tuturor marilor modele de azi. Partea ei cea mai importantă se numește atenție.
Gândește-te la operatorul de lumini de la un concert. Muzica se schimbă, iar el decide pe cine luminează: în timpul solo-ului de chitară, reflectorul cade pe chitarist; când începe vocea, pe solist. Atenția funcționează asemănător. Pentru fiecare cuvânt, modelul decide spre care dintre celelalte cuvinte să își „îndrepte reflectorul”.
Un exemplu: „Valiza nu a încăput în mașină pentru că era prea mare.” Ce era prea mare? Evident, valiza. Gramatica nu ajută aici: „valiza” și „mașina” sunt amândouă feminine, deci „era” se poate referi la oricare. Dacă schimbi un singur cuvânt, „Valiza nu a încăput în mașină pentru că era prea mică”, răspunsul se inversează: acum mașina era prea mică. Singurul indiciu e sensul. Mecanismul de atenție îl prinde pentru că modelul a văzut în milioane de texte cum funcționează obiectele care „nu încap” unele în altele.
Tot aici se rezolvă și cuvintele cu mai multe sensuri. În „Am auzit o broască oracăind în lac”, atenția leagă „broască” de „oracăind” și „lac”. În „S-a stricat broasca de la ușă”, o leagă de „ușă”. Cuvântul a pornit de la aceeași poziție pe hartă, dar acum vectorul lui se îmbogățește cu sensul potrivit contextului.
Acest calcul nu se face o singură dată. Se face simultan din mai multe „unghiuri”, fiecare atent la alt tip de relație: unul la gramatică, altul la cine face ce, altul la ton. Apoi întreg stratul se repetă de zeci de ori, unul peste altul. Un model ca Llama 3 de 70 de miliarde de parametri are 80 de astfel de straturi. Cu fiecare strat, înțelegerea devine mai abstractă și mai bogată.
La final, vectorul ultimului cuvânt nu mai reprezintă doar acel cuvânt. Conține un fel de rezumat al întregului text de până atunci, util pentru a decide ce urmează.
Pasul 4: o notă pentru fiecare continuare posibilă
Modelul a „înțeles” contextul. Acum trebuie să răspundă la o singură întrebare: ce token urmează?
Nu alege direct unul. În schimb, dă o notă fiecărui token din vocabular, adică tuturor celor aproximativ 100.000. Notele sunt apoi transformate în probabilități care, adunate, dau 100%. Pentru textul „Cel mai înalt munte din România este”, rezultatul ar putea arăta așa:
Următorul token | Probabilitate (ilustrativă) |
|---|---|
Moldoveanu | 81% |
vârful | 9% |
situat | 3% |
Negoiu | 2% |
…alte câteva zeci de mii de variante | restul |
Exemplul e simplificat: în realitate, un cuvânt mai rar, ca „Moldoveanu”, ar fi probabil împărțit în mai mulți tokeni, aleși unul după altul.
Aici e un adevăr esențial despre aceste programe: modelul nu produce „răspunsul”. Produce o distribuție de probabilități peste toate continuările posibile. Răspunsul pe care îl citești e doar un drum ales printr-un spațiu uriaș de variante.
Observă și că „Negoiu”, un răspuns greșit, are totuși o probabilitate. E un munte real, apare des în texte lângă „Moldoveanu” și „cel mai înalt”. Pentru model, el e o continuare plauzibilă, chiar dacă nu e cea corectă. Vom reveni la asta când vorbim despre greșeli.
Pasul 5: se alege un singur token
Cea mai simplă metodă ar fi să alegi mereu varianta cu probabilitatea cea mai mare. Rezultatul ar fi consecvent, dar adesea monoton și repetitiv. De aceea, majoritatea sistemelor „trag la sorți” dintre variante, ținând cont de probabilități. O variantă cu 81% iese de cele mai multe ori, dar nu întotdeauna.
Acest lucru explică un fenomen pe care probabil l-ai observat: dacă pui aceeași întrebare de două ori, primești răspunsuri ușor diferite.
Cât de mult „risc” își asumă modelul se reglează printr-o setare numită temperatură:
- Temperatură mică: variantele cele mai probabile domină aproape complet. Răspunsurile sunt previzibile și sigure, potrivite pentru calcule, cod sau extragerea de date.
- Temperatură mare: și variantele mai puțin probabile primesc o șansă reală. Textul devine mai variat, ceea ce poate ajuta la scriere creativă. Împinsă prea sus, însă, temperatura duce la fraze incoerente.
Temperatura nu face modelul „mai creativ” în sens omenesc. Îl face doar să aleagă mai des variante neobișnuite. Faptul că rezultatul ni se pare creativ e o interpretare a noastră.
În aplicațiile de chat, temperatura e de obicei setată de firmă și nu o poți schimba. Programatorii care folosesc modelele direct o pot regla, deși la unele modele recente nici ei nu mai au acces la această setare.
Bucla: și apoi totul se repetă
Am obținut un singur token. Un răspuns are însă sute. Tokenul ales e adăugat la text, iar procesul se reia pentru următorul. Să zicem că ai întrebat „Ce este Python?”:
- Modelul vede „Ce este Python?” și alege „Python”.
- Vede „Ce este Python? Python” și alege „este”.
- Vede „Ce este Python? Python este” și alege „un”.
- …și tot așa, până când alege un token special care înseamnă „gata” sau atinge o limită de lungime.
În practică, modelul nu refă de la zero calculele pentru tot textul la fiecare pas. Păstrează ce a calculat deja pentru tokenii anteriori și calculează doar pentru cel nou. Totuși, fiecare token nou trebuie să „se uite” la toți cei de dinainte, așa că textele foarte lungi devin tot mai costisitoare.
Știe modelul dinainte ce va spune?
Multe explicații populare spun că nu: că modelul nu are nicio idee unde ajunge fraza și decide totul cuvânt cu cuvânt. E doar parțial adevărat.
Corect este că nu există un răspuns scris dinainte, ascuns undeva și copiat pe ecran. Fiecare token e ales efectiv abia când îi vine rândul. Dar cercetările recente arată că, în interiorul modelului, lucrurile sunt mai subtile. Studii de interpretabilitate publicate în 2025 de Anthropic au observat că, atunci când un model scrie o poezie, el „alege” cuvântul care trebuie să rimeze înainte de a ajunge la finalul versului, apoi construiește versul spre el.
Cu alte cuvinte, modelul alege bucată cu bucată, dar starea lui internă anticipează deja direcția. E puțin ca la un om care vorbește: nu are fiecare cuvânt pregătit, dar știe în mare ce vrea să spună.
Ce mai adaugă asistenții de azi
Două lucruri completează imaginea. Primul: multe modele din 2025–2026 sunt modele care „gândesc” înainte să răspundă. Ele generează întâi, cu același mecanism token cu token, un șir de raționamente intermediare, adesea ascunse sau doar rezumate pentru utilizator, și abia apoi scriu răspunsul. La probleme de matematică, logică sau programare, acest pas suplimentar îmbunătățește vizibil rezultatele.
Al doilea: într-o aplicație de chat, modelul nu vede doar mesajul tău. Înaintea lui primește și instrucțiuni ascunse de la firma care îl oferă, numite system prompt: cum să se comporte, ce ton să folosească, ce unelte are la dispoziție. Pentru model, toate acestea sunt tot text, citit înaintea întrebării tale. Vom reveni la ambele subiecte în articolele următoare.
Ce înseamnă asta pentru tine: trei lucruri utile
1. Când modelul „inventează”, nu minte
Uneori, un asistent AI îți spune cu toată încrederea un fapt fals: o carte care nu există, o lege inventată, o dată greșită. Fenomenul se numește halucinație. Acum e mai ușor de înțeles de ce apare.
Modelul produce text care seamănă cu un răspuns corect și sigur pe el. Probabilitățile de la pasul 4 măsoară cât de plauzibilă e o continuare, nu dacă e adevărată. De cele mai multe ori, plauzibil și adevărat coincid. Când nu coincid, apare greșeala, la fel de convingător formulată ca un răspuns corect.
Concluzia practică: verifică faptele importante, mai ales cifre, nume, citate și surse. Tonul sigur al răspunsului nu e o garanție. Asistenții care pot căuta pe internet și îți arată sursele reduc riscul, dar nu îl elimină.
2. Același prompt poate da răspunsuri diferite
Pentru că tokenii sunt aleși prin tragere la sorți ponderată, două încercări cu aceeași întrebare nu dau același text. Nu e o eroare, ci felul în care funcționează sistemul.
Concluzia practică: dacă un răspuns nu te mulțumește, cere-l din nou sau reformulează întrebarea. Și invers: dacă ai nevoie de rezultate identice de fiecare dată, un asistent AI nu e unealta potrivită fără verificare suplimentară.
3. Limitele de lungime au un motiv tehnic
Fiecare model are o limită a textului pe care îl poate „ține minte” într-o conversație, numită fereastră de context. Cauza ține parțial de pasul 3: fiecare token trebuie să se uite la toți ceilalți, iar costul crește foarte repede cu lungimea textului. Contează și memoria hardware-ului, felul în care a fost antrenat modelul și deciziile de cost ale firmei.
Concluzia practică: în conversațiile foarte lungi, modelul poate „uita” sau poate da mai puțină atenție detaliilor de la început. Pentru un subiect nou, e adesea mai bine să pornești o conversație nouă. Și, cum am văzut, în română limita se umple mai repede decât în engleză.
Pe scurt
Data viitoare când folosești ChatGPT, Claude sau orice alt asistent AI, poți să-ți imaginezi ce se întâmplă în spate. Textul tău e tăiat în tokeni. Fiecare token primește un loc pe o hartă a sensurilor. Mecanismul de atenție leagă cuvintele între ele și clarifică contextul. Modelul dă o probabilitate fiecărei continuări posibile, apoi alege una. Și repetă totul, token cu token, până la final.
Nu e magie, ci un mecanism. Iar înțelegerea lui te ajută să folosești aceste unelte mai bine: să știi când să ai încredere în ele și când să verifici.
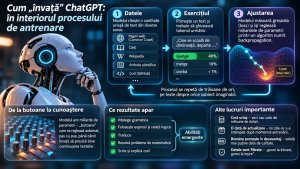
În articolul următor: de unde „știe” modelul toate acestea? Vom vedea cum e antrenat un LLM, ce citește, cum învață să fie un asistent util și de ce are o dată după care nu mai știe ce s-a întâmplat în lume.
Surse
- Vaswani și colaboratorii, „Attention Is All You Need” (2017), lucrarea care a introdus arhitectura Transformer: arxiv.org/abs/1706.03762
- Mikolov și colaboratorii, „Efficient Estimation of Word Representations in Vector Space” (2013), lucrarea word2vec: arxiv.org/abs/1301.3781
- Meta, „The Llama 3 Herd of Models” (2024), cu arhitectura modelului Llama 3 70B: arxiv.org/abs/2407.21783
- Anthropic, „Tracing the thoughts of a large language model” (27 martie 2025), despre planificarea rimei în poezii: anthropic.com/research/tracing-thoughts-language-model